10 patrones de microservicios, en orden cronológico
El pago pasó. El inventario falló. El cliente vuelve a pulsar el botón porque la pantalla sigue esperando. ¿Qué necesita ese sistema: una saga, un circuit breaker, una cola o simplemente un timeout bien puesto?
La lista de nombres no responde la pregunta. Yo prefiero empezar por lo que se rompió, seguir con la decisión que lo corrige y terminar con el costo de mantenerla. Cuando recorres los patrones así, dejan de ser respuestas para memorizar y empiezan a servir para diseñar.
Voy a usar un mismo ejemplo: un pedido de una tienda en línea que necesita cobrar, reservar inventario y preparar el envío. Es un ejemplo ilustrativo, no la descripción de un incidente real. Nos permite cambiar una decisión y ver qué consecuencias tiene sobre el resto.
Antes de empezar: qué significan estas fechas
Muchos patrones usados en microservicios nacieron fuera de ellos. Las transacciones largas, el aislamiento de recursos y la mensajería fiable son problemas anteriores a los contenedores.
Por eso ordeno hitos documentados, no certificados de invención. Un artículo, un libro o un lanzamiento nos da un punto de referencia; no demuestra que nadie lo hubiera hecho antes. Tampoco hay una evolución obligatoria donde cada patrón deba reemplazar al anterior.
| Hito | Patrón | Problema que voy a seguir |
|---|---|---|
| 1987, paper Sagas | Saga | Coordinar trabajo que no cabe en una transacción larga. |
| 2004, artículo de Fowler | Strangler Fig | Sustituir un sistema sin una reescritura de una sola vez. |
| 2005, descripción de Fowler | Event Sourcing | Conservar los cambios que explican el estado. |
| 2007, Release It! | Circuit Breaker | Dejar de llamar temporalmente a una dependencia que falla. |
| 2007, el mismo libro | Bulkhead | Limitar cuánto daño puede provocar una dependencia. |
| Hacia 2009–2010, difusión de CQRS | CQRS | Diseñar modelos distintos para escribir y consultar. |
| 2013, anuncio público de Zuul | API Gateway | Dar a los clientes una entrada controlada. |
| 2016, paper de Burns y Oppenheimer | Sidecar | Separar una capacidad auxiliar del proceso principal. |
| 2016–2017, Linkerd e Istio | Service Mesh | Gobernar comunicación entre servicios. |
| 2018, Microservices Patterns | Transactional Outbox | Guardar un cambio y su intención de publicación atómicamente. |
Las fuentes originales están enlazadas en cada tramo y reunidas al final. Cuando una fecha representa difusión o catalogación, la nombro de esa manera.
1987 · Saga: terminar un proceso sin una transacción gigante
El antecedente. Héctor García-Molina y Kenneth Salem publicaron Sagas en 1987, pensando en transacciones largas de base de datos. Los microservicios recuperaron la idea para coordinar operaciones repartidas.
El problema. Pedidos guarda la compra, Pagos cobra e Inventario intenta reservar unidades. Si ese último paso falla, una transacción local en Pedidos no puede deshacer lo confirmado en las otras bases. Mantener recursos bloqueados mientras todos responden tampoco resulta una solución gratuita.
La idea. Dividir el proceso en transacciones locales y definir qué hacer ante un fallo. Una compensación revierte el efecto de negocio de un paso: reembolsar el pago, por ejemplo. No restaura automáticamente el mundo al instante anterior; un correo enviado ya fue leído y un reembolso puede tardar.
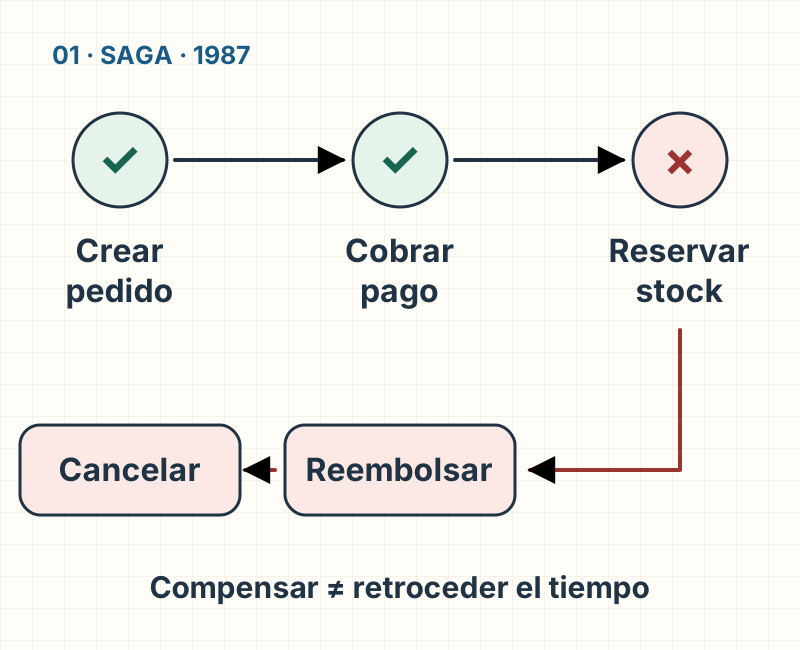
En orquestación, un coordinador mantiene el recorrido y ordena los pasos. En coreografía, los participantes reaccionan a eventos. La primera hace visible el proceso; la segunda distribuye la coordinación. En ambos casos necesitas saber en qué estado quedó el pedido y quién se ocupa del próximo intento.
El costo y cuándo sobra. Una saga no ofrece por sí sola aislamiento global: otros procesos pueden observar estados intermedios. Yo empezaría con una transacción local cuando todo el cambio pertenece a la misma frontera. Si necesitas una invariante inmediata entre participantes, revisa primero esa frontera; añadir compensaciones no la hace verdadera.
La pregunta de entrevista. ¿Qué pasa si falla el reembolso? La compensación necesita idempotencia, reintentos controlados y seguimiento persistente. Si no se recupera, debe existir una ruta de resolución operativa. Un mensaje de error perdido no es una estrategia.
2004 · Strangler Fig: reemplazar por partes
El antecedente. La metáfora de Martin Fowler aparece en su publicación del 29 de junio de 2004. El punto útil sigue siendo desplazar funcionalidad gradualmente y obtener valor antes de acabar la sustitución.
El problema. Quieres reemplazar el checkout antiguo. Mientras construyes el nuevo, el negocio sigue cambiando descuentos, impuestos y formas de envío. Si esperas a reproducirlo todo para cambiar de sistema, el destino se sigue moviendo.
La idea. Introducir un punto de intercepción y mover capacidades de forma incremental. Puedes empezar por consultar el estado del pedido y dejar el cobro donde está. El sistema nuevo gana responsabilidad a medida que compruebas resultados y retiras la implementación vieja.
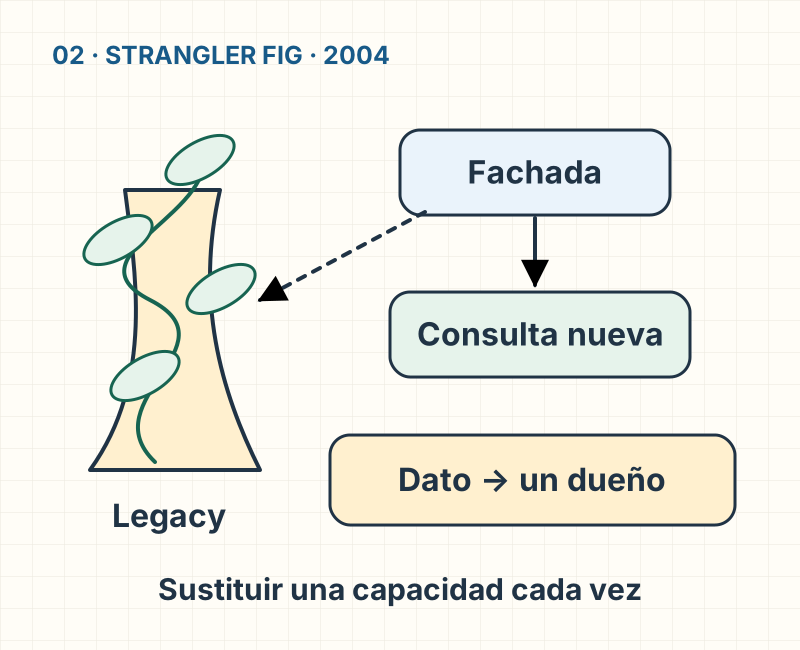
El costo y cuándo sobra. Durante un tiempo mantienes dos implementaciones, traducciones entre modelos y procedimientos de convivencia. El trabajo difícil suele estar en los datos: quién escribe cada dato y cómo se consulta durante la transición. Las escrituras dobles improvisadas crean dos verdades que después hay que reconciliar.
No concluiría que un sistema muy acoplado vuelve imposible el patrón. Puede exigir crear una frontera antes de migrar. Pero si el componente es pequeño, está bien probado y puede sustituirse con un cambio acotado, una convivencia larga quizá cueste más que el reemplazo.
La pregunta de entrevista. ¿Qué migrarías primero? Una capacidad con responsabilidad de datos clara, riesgo manejable y una forma de comprobar equivalencia. Antes de redirigir tráfico, definiría señales de error, criterio de éxito y regreso al recorrido anterior. El porcentaje migrado sirve poco si compras incorrectas parecen exitosas.
2005 · Event Sourcing: guardar cómo llegaste aquí
El antecedente. Fowler publicó su descripción de Event Sourcing en diciembre de 2005. La idea de registros históricos es anterior; esta referencia documenta una formulación del patrón de aplicación.
El problema. La fila del pedido dice CANCELADO, pero ya no explica qué se confirmó, qué se cobró y por qué se canceló. Si esas transiciones forman parte del negocio, conservar solo el resultado puede ser insuficiente.
La idea. Persistir eventos de dominio como fuente de verdad y reconstruir el estado aplicándolos en orden. PedidoCreado, LineaAgregada y PedidoCancelado describen hechos con significado, no simples diferencias de columnas.
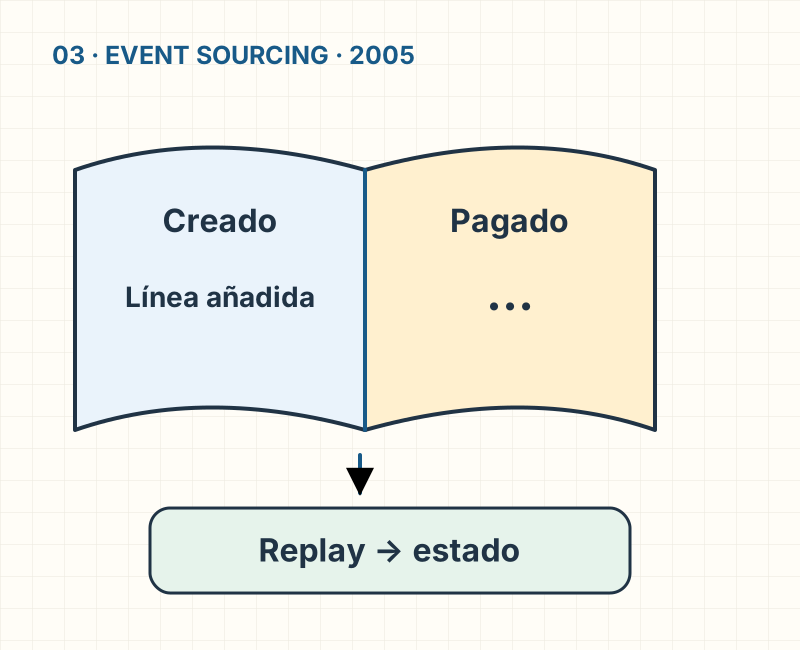
El costo y cuándo sobra. Necesitas gestionar concurrencia, evolución de esquemas, tiempos de reconstrucción y efectos externos. Reproducir el historial para reconstruir un estado no debe volver a cobrar al cliente. También debes diseñar el ciclo de vida de los datos personales antes de guardarlos en eventos duraderos.
Yo no elegiría Event Sourcing únicamente para tener auditoría. Un registro de auditoría puede acompañar un modelo de estado actual sin convertir la reconstrucción por eventos en el corazón del sistema. Los snapshots son otra herramienta con costo: hay que poder invalidarlos o regenerarlos cuando cambie la interpretación del historial.
La pregunta de entrevista. ¿Qué haces cuando cambia la forma de un evento? Puedes mantener lectores compatibles, versionar el esquema y usar upcasting para transformar representaciones antiguas al leer. Eso conserva la interpretación histórica; no implica fingir que un hecho pasado ocurrió de otra manera.
2007 · Circuit Breaker: dejar de insistir por un rato
El antecedente. Release It!, de Michael Nygard, es una referencia de estabilidad publicada en 2007; el propio autor anunció su distribución ese abril. Aquí uso el libro como hito de difusión.
El problema. El proveedor de pagos tarda demasiado y cada llamada consume una conexión o un hilo. Los pedidos siguen llegando. Reintentar más puede aumentar la carga sobre una dependencia que ya no está atendiendo.
La idea. El circuito cerrado permite llamadas y observa resultados. Si se supera el criterio de fallo, pasa a abierto y rechaza llamadas sin contactar al proveedor. Tras una espera entra en semiabierto, permite unas pocas sondas y decide si cerrar o volver a abrir.
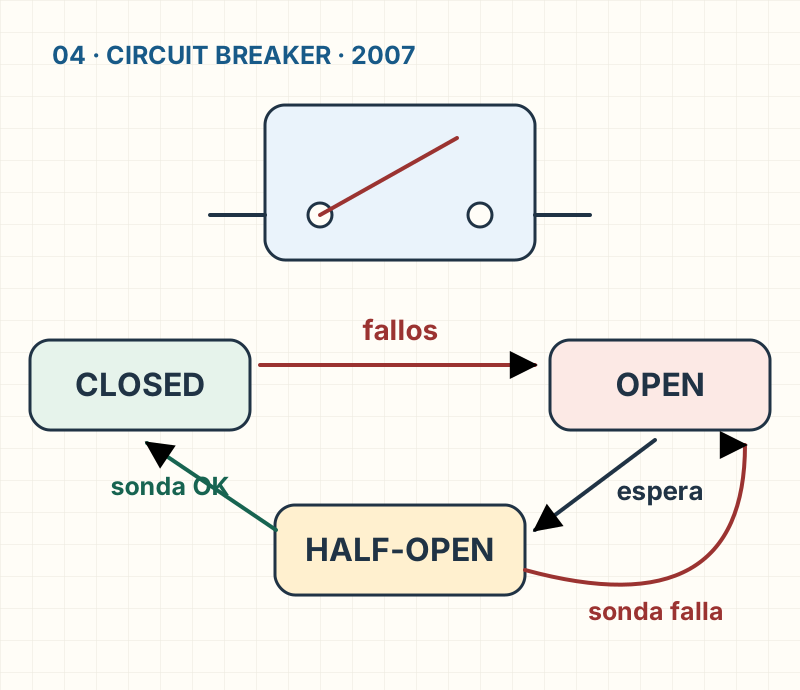
El costo y cuándo sobra. Hay que elegir qué resultados cuentan como fallo y cuánto observar. Una tarjeta rechazada por una regla de negocio no demuestra que el servicio esté roto. Un umbral mal elegido puede bloquear un proveedor sano o tardar demasiado en protegerte.
El patrón complementa los timeouts y presupuestos de reintento. Puede fallar rápido sin un fallback: el resultado aceptable podría ser avisar que no se pudo completar la operación. En pagos, inventar un éxito como alternativa sería peor que mostrar el fallo.
La pregunta de entrevista. ¿Cuántas sondas permitirías? Las suficientes para decidir con carga controlada, según el comportamiento del proveedor. También coordinaría reintentos y límite de concurrencia: una recuperación no debería disparar una nueva avalancha.
2007 · Bulkhead: que una fuga no hunda todo
El antecedente. El mismo Release It! describe el aislamiento de recursos con la metáfora de los compartimentos de un barco. La idea es contener el daño, en lugar de apostar a que ninguna dependencia falle.
El problema. Pagos y recomendaciones comparten un pool. El servicio de recomendaciones se vuelve lento y ocupa toda la capacidad. Ahora tampoco puedes cobrar, aunque el proveedor de pagos funciona bien.
La idea. Asignar límites o compartimentos a cargas distintas. Pueden ser semáforos de concurrencia, pools de conexiones, colas con capacidad acotada o instancias separadas. La implementación depende del recurso que realmente se agota.
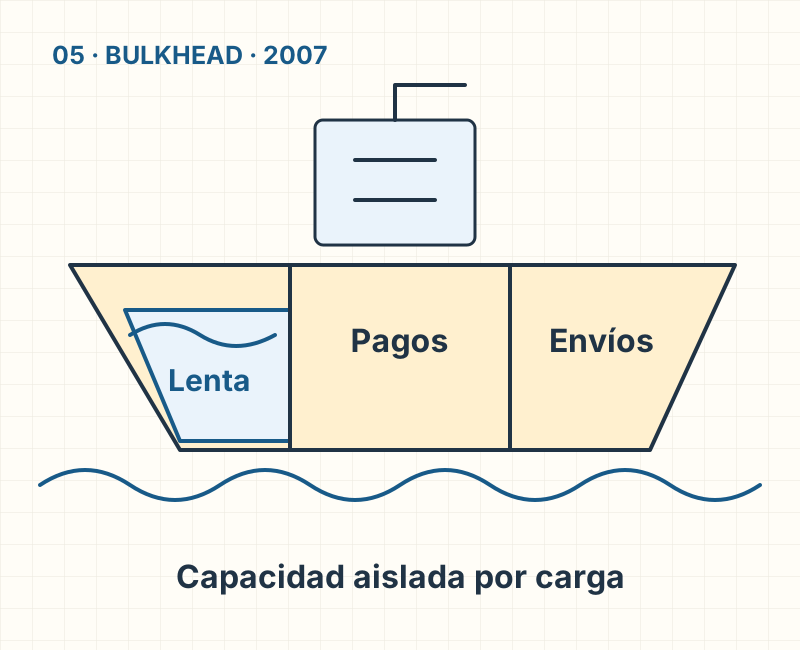
El costo y cuándo sobra. Una división rígida puede desperdiciar capacidad disponible y crear colas nuevas. Si decides aislar por cliente, necesitas límites que no permitan a un cliente ruidoso consumir también la infraestructura compartida que quedó debajo.
No daría un pool de hilos a cada llamada por costumbre. Con programación asíncrona o hilos virtuales todavía existen conexiones, memoria y capacidad del proveedor que conviene limitar. El mecanismo debe proteger ese recurso, no reproducir una receta para otro modelo de ejecución.
La pregunta de entrevista. ¿En qué se diferencia del circuit breaker? El bulkhead acota el consumo de recursos; el breaker decide cuándo dejar de invocar una dependencia según sus resultados. Pueden trabajar juntos: uno contiene mientras el otro detecta y corta. Ninguno vuelve ilimitada la capacidad que queda.
Hacia 2009–2010 · CQRS: dos modelos, dos trabajos
El antecedente. CQRS se asocia a Greg Young y al principio CQS de Bertrand Meyer. Evito fijar su nacimiento en 2010: Udi Dahan ya publicó Clarified CQRS el 9 de diciembre de 2009. Fowler describe después la separación de modelos y sus variantes.
El problema. El modelo que valida un pedido tiene reglas y relaciones que la pantalla de seguimiento no necesita. A la vez, la pantalla requiere una vista que combina estado, pago y envío. Forzar ambas tareas dentro del mismo modelo puede complicar las dos.
La idea. Diseñar comandos para expresar cambios y un modelo de consulta para responder preguntas. ConfirmarPedido protege las reglas; ConsultarSeguimiento devuelve los datos que necesita la pantalla. La separación puede existir en una misma aplicación y con una sola base de datos.
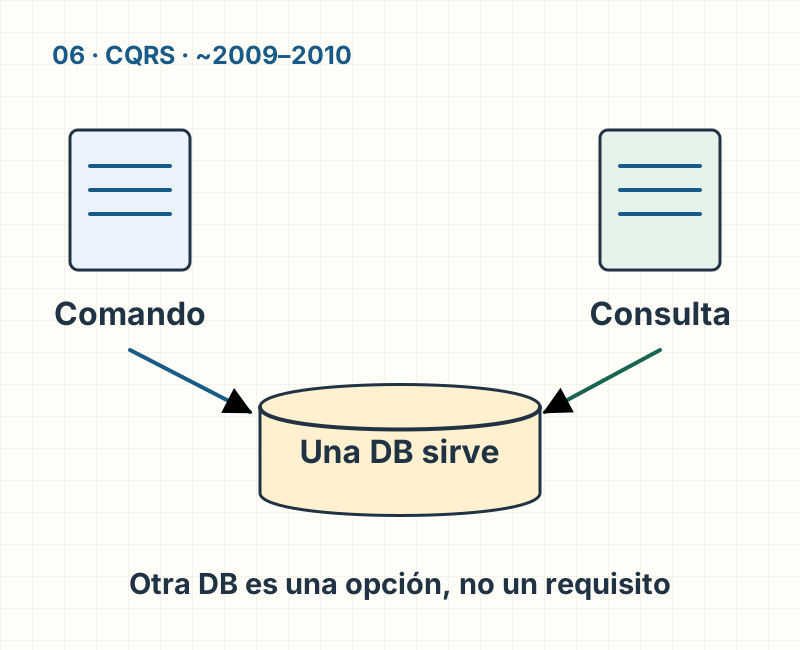
El costo y cuándo sobra. Mantienes dos representaciones y necesitas decidir cómo se actualiza la de lectura. Si es asíncrona, la pantalla puede ir detrás del cambio confirmado. Ese retraso necesita una experiencia de usuario consciente: estado pendiente, confirmación o una lectura adecuada al caso.
En un CRUD sencillo yo mantendría la solución sencilla. Una consulta lenta también puede resolverse con un índice o una consulta especializada. No toda diferencia entre leer y escribir necesita una arquitectura nueva.
La pregunta de entrevista. ¿CQRS implica Event Sourcing? No. Puedes separar modelos con estado actual, sin publicar eventos. También puedes usar eventos para actualizar una proyección sin convertir el historial de eventos en la fuente de verdad.
2013 · API Gateway: una entrada controlada
El antecedente. El anuncio público de Zuul de Netflix en 2013 es un hito reconocible de este recorrido. No significa que Netflix inventara los gateways ni que toda API necesite uno.
El problema. La aplicación móvil conoce las direcciones de Pedidos, Pagos y Envíos. Cada servicio exige sus propias decisiones de autenticación y versiones. Cambiar la topología interna empieza a obligar a cambiar los clientes.
La idea. Colocar una entrada que enrute y aplique políticas comunes: autenticación, límites de solicitudes y terminación TLS, entre otras. Un BFF adapta una interfaz al tipo de cliente; puede combinarse con un gateway, pero su propósito no es exactamente el mismo.
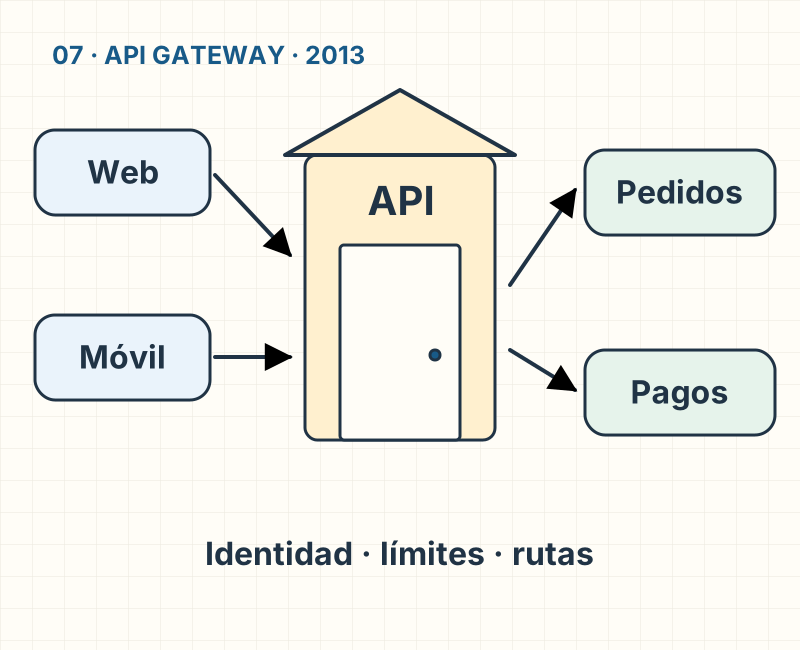
El costo y cuándo sobra. Es otro salto de red y una pieza operativa crítica. Hay que dimensionarla, replicarla y medirla. Un punto lógico de entrada no obliga a tener una sola instancia física, pero concentrar todo en una instancia sí crea un punto de fallo.
Si solo tienes una API pequeña detrás de un proxy existente, un gateway adicional puede aportar poco. Yo separaría con cuidado las políticas comunes de las reglas de negocio: decidir qué pedido se puede cancelar no debería acabar disperso entre rutas del gateway.
La pregunta de entrevista. ¿Gateway o mesh? Son responsabilidades complementarias. El gateway atiende el acceso de clientes al sistema; el mesh gobierna comunicación entre cargas. Las implementaciones pueden compartir tecnología de proxy, sin convertirse por eso en la misma decisión.
2016 · Sidecar: un compañero para la aplicación
El antecedente. Brendan Burns y David Oppenheimer describen el patrón en Design Patterns for Container-based Distributed Systems, HotCloud 2016. Es una referencia documental, no el inicio de todos los procesos auxiliares.
El problema. Varios servicios necesitan una capacidad similar, como recoger logs o proporcionar un proxy local. Implementarla dentro de cada aplicación puede duplicar integración y atarla al lenguaje o a las dependencias del servicio.
La idea. Ejecutar un componente auxiliar junto a la aplicación. En Kubernetes, el ejemplo habitual es otro contenedor del mismo pod: comparte la red del pod y se administra dentro de esa unidad de despliegue. La aplicación y el auxiliar siguen siendo procesos distintos.
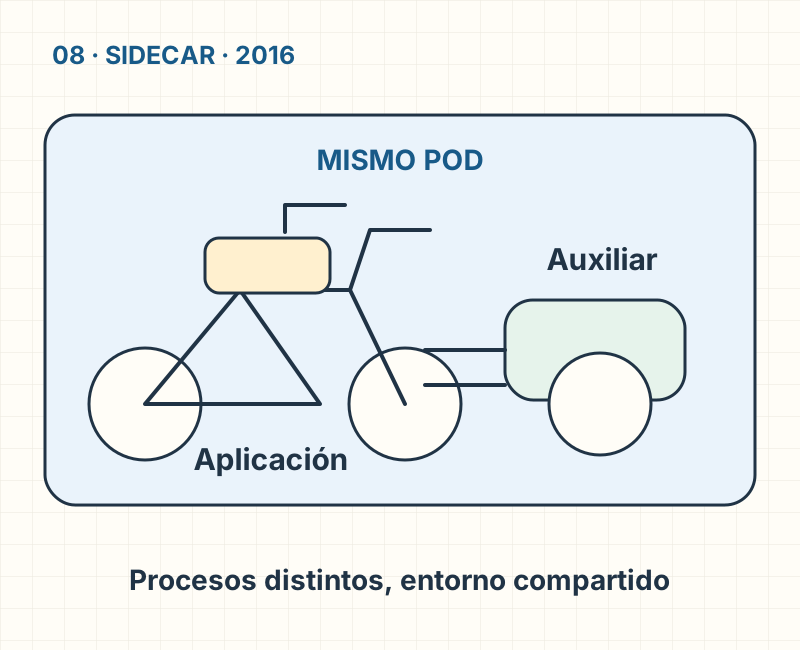
El costo y cuándo sobra. El auxiliar consume recursos y puede introducir latencia si participa en cada solicitud. También añade coordinación de arranque, apagado y salud. Separar la imagen no significa poder cambiarla sin considerar la unidad de despliegue: actualizar un pod puede afectar a ambos contenedores.
Yo compararía esa operación con una librería pequeña o un agente compartido cuando el costo por instancia sea mayor que el beneficio. En entornos administrados hay que comprobar qué modelo de ejecución permite realmente la plataforma.
La pregunta de entrevista. ¿Por qué no una librería? El sidecar puede servir a aplicaciones en lenguajes distintos y tener dependencias propias. A cambio, agrega comunicación entre procesos y operación. Esa independencia de implementación se paga; no siempre conviene.
2016–2017 · Service Mesh: gobernar la comunicación
El antecedente. Linkerd se lanzó en 2016; Istio comenzó con sidecars en 2017. Uso ese período para situar la difusión de una capa de infraestructura dedicada a la comunicación entre servicios.
El problema. Cada equipo configura de forma distinta identidad, cifrado, observabilidad y tratamiento de fallos en las llamadas. Cuando cambias una política, debes conseguir que las distintas implementaciones se comporten de manera compatible.
La idea. Separar un plano de datos, por donde pasa el tráfico, de un plano de control, que configura políticas e identidades. Un mesh con sidecars coloca proxies junto a las aplicaciones; es una implementación, no la definición completa.
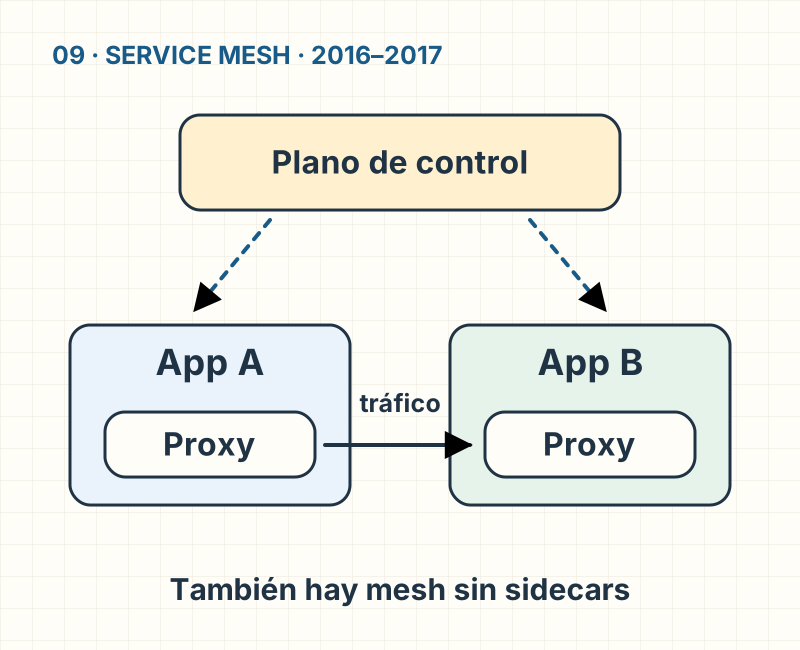
La documentación de Istio distingue sidecar y ambient. Este último permite un plano de datos sin un sidecar por pod. Por eso mantengo Sidecar y Service Mesh como dos patrones relacionados, con alcances distintos.
El costo y cuándo sobra. Añades infraestructura de red, certificados, configuración y nuevas formas de fallo. Con pocos servicios y políticas simples, puede ser más fácil operar las capacidades existentes. La observabilidad que ganas también debe ayudarte a entender al propio mesh.
La pregunta de entrevista. ¿Qué sale del código? Parte del comportamiento de transporte puede configurarse en la infraestructura. La idempotencia del pago, el significado de una respuesta y los permisos de negocio siguen necesitando decisiones en la aplicación. Además, los retries del mesh y del cliente deben compartir un presupuesto para no multiplicar intentos.
2018 · Transactional Outbox: cerrar la doble escritura
El antecedente. Chris Richardson lo recoge en Microservices Patterns, publicado en 2018, y en su catálogo de patrones. Es una fecha de catalogación; la necesidad de mensajería fiable es anterior.
El problema. Confirmas el pedido en la base y después publicas un evento. El proceso cae entre ambos pasos. El pedido existe, pero Inventario nunca recibe la noticia. Invertir el orden tampoco vuelve atómicas las dos escrituras.
La idea. Guardar el cambio de negocio y un registro pendiente de publicación dentro de la misma transacción local. Después, un relay publica ese registro mediante polling o lectura del log de cambios. Si el proceso se reinicia, la intención de publicar sigue persistida.
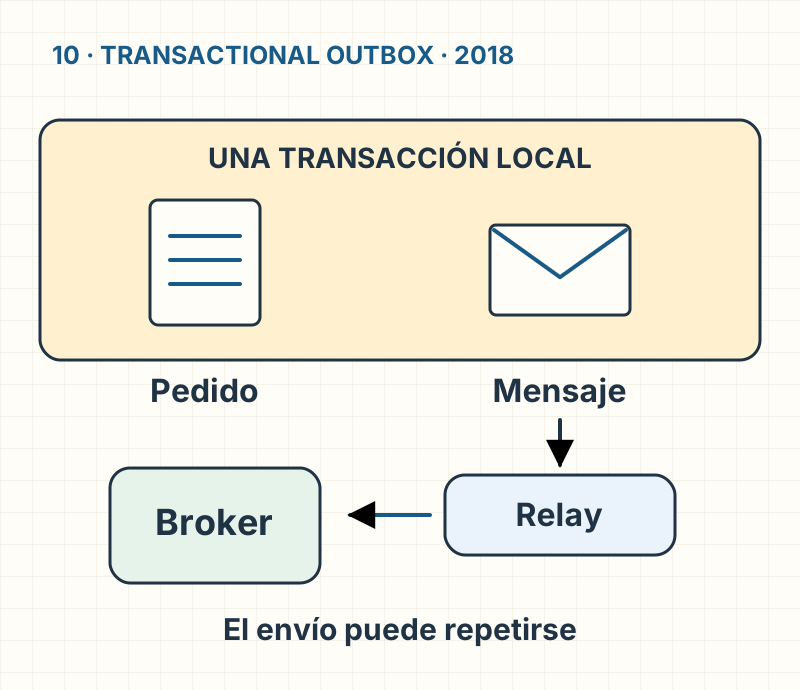
El costo y cuándo sobra. Debes operar el relay, vigilar retrasos, limpiar registros y conservar el orden necesario por agregado. Si el relay publica y cae antes de registrar el resultado, puede publicar otra vez. El consumidor debe tolerarlo sin duplicar efectos; marcar un evento como visto y aplicar el efecto también necesita consistencia.
Si no hay nada que publicar fuera de la transacción, no necesitas una outbox. Event Sourcing puede resolver la persistencia del hecho y servir como origen de publicación, pero tener un event store no garantiza su entrega a otro broker. Todavía necesitas suscripciones, checkpoints o un mecanismo fiable equivalente.
La pregunta de entrevista. ¿Hay entrega exactamente una vez? Este patrón por sí solo no promete eso. Yo diseñaría para repetición: identificador estable, efectos idempotentes, seguimiento y recuperación. El objetivo es que un reintento no cobre ni reserve dos veces.
Cómo se conectan sin convertirse en una lista de compras
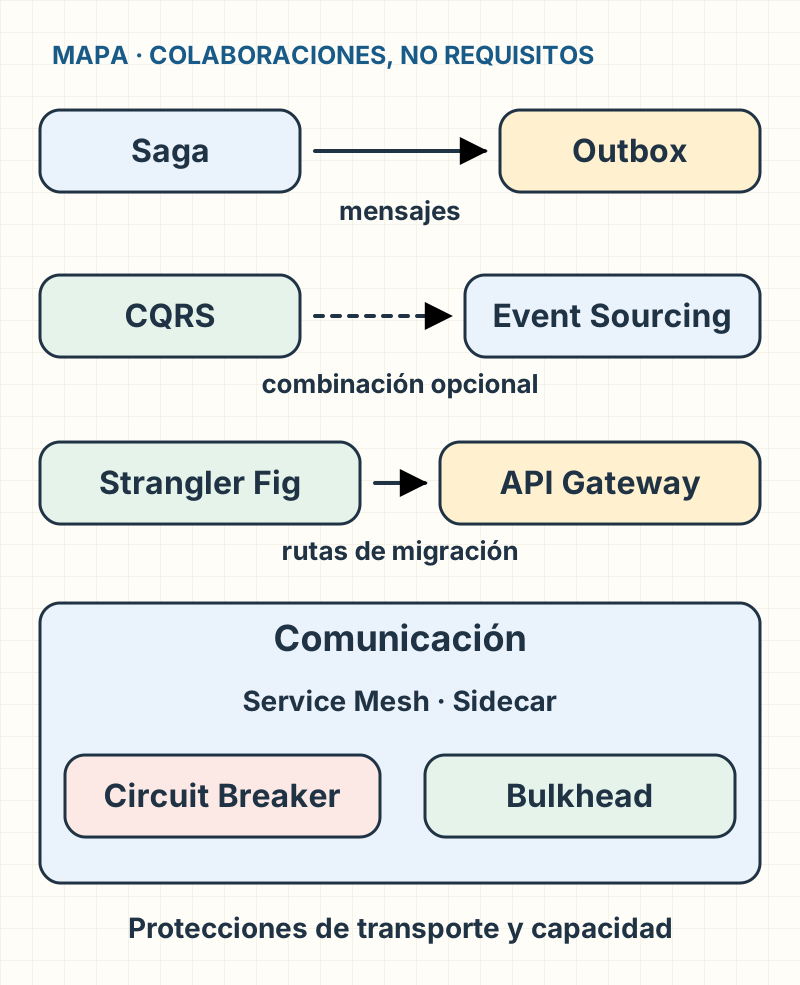
La saga coordina pasos de negocio; la outbox ayuda a publicar los mensajes que esos pasos necesitan. CQRS separa modelos; Event Sourcing cambia la fuente de verdad. Pueden combinarse, pero una relación útil no es una dependencia obligatoria.
Si quieres recorrer cómo aparecen algunas de estas decisiones al construir un sistema, dejé ese otro ángulo en De DDD a Event Sourcing: la cadena de problemas. Aquí la pregunta es más acotada: qué problema concreto justifica cada pieza.
La decisión que tomaría antes de añadir una pieza
| Si el problema es… | Evaluaría… | Primero comprobaría… |
|---|---|---|
| Un proceso cruza varias transacciones locales | Saga | Si las fronteras pueden simplificarse; quién resuelve estados pendientes. |
| Sustituir un sistema con riesgo controlado | Strangler Fig | Propiedad de datos, equivalencia y vuelta atrás. |
| Reconstruir decisiones pasadas del dominio | Event Sourcing | Si un historial de auditoría más sencillo es suficiente. |
| Fallos remotos que provocan cascadas | Circuit Breaker | Timeouts, clasificación de fallos y presupuesto de reintentos. |
| Una carga consume toda la capacidad | Bulkhead | Qué recurso se agota y qué aislamiento ya existe. |
| Un modelo dificulta escribir y consultar | CQRS | Si consultas especializadas o índices resuelven el dolor. |
| Clientes acoplados a múltiples servicios | API Gateway | Si el proxy actual basta y quién opera la nueva entrada. |
| Una capacidad auxiliar debe acompañar a cada instancia | Sidecar | Si conviene una librería o un agente compartido. |
| Políticas de comunicación difíciles de gobernar | Service Mesh | Capacidad operativa y necesidades medibles de seguridad y tráfico. |
| Un cambio confirmado debe producir un mensaje fiable | Transactional Outbox | Duplicados, orden, retraso y recuperación del relay. |
Lo que debes llevarte: antes de preguntar cómo implementar un patrón, escribe qué fallo quieres evitar, qué garantía necesitas y qué costo puedes operar.
Esa es la parte que me interesa de conocer su historia. Te devuelve al problema antes de elegir la herramienta. Y deja espacio para una respuesta que también demuestra criterio: con las necesidades de hoy, todavía no hace falta.
¿Cuál de estos problemas tienes ahora, y qué evidencia te haría decidir que ya necesitas el patrón?
Referencias para seguir el recorrido
- García-Molina y Salem: Sagas, SIGMOD 1987.
- Fowler: Strangler Application, 2004, Event Sourcing, 2005 y CQRS, 2011.
- Nygard: publicación de Release It!, 2007.
- Dahan: Clarified CQRS, 2009.
- Netflix: Announcing Zuul, 2013.
- Burns y Oppenheimer: Design Patterns for Container-based Distributed Systems, 2016.
- CNCF: Linkerd 2.0 y antecedentes del lanzamiento de 2016.
- Istio: modos de plano de datos.
- Richardson: Microservices Patterns, 2018, Saga y Transactional Outbox.